Testování pamětí (M68k @ 10 MHz)
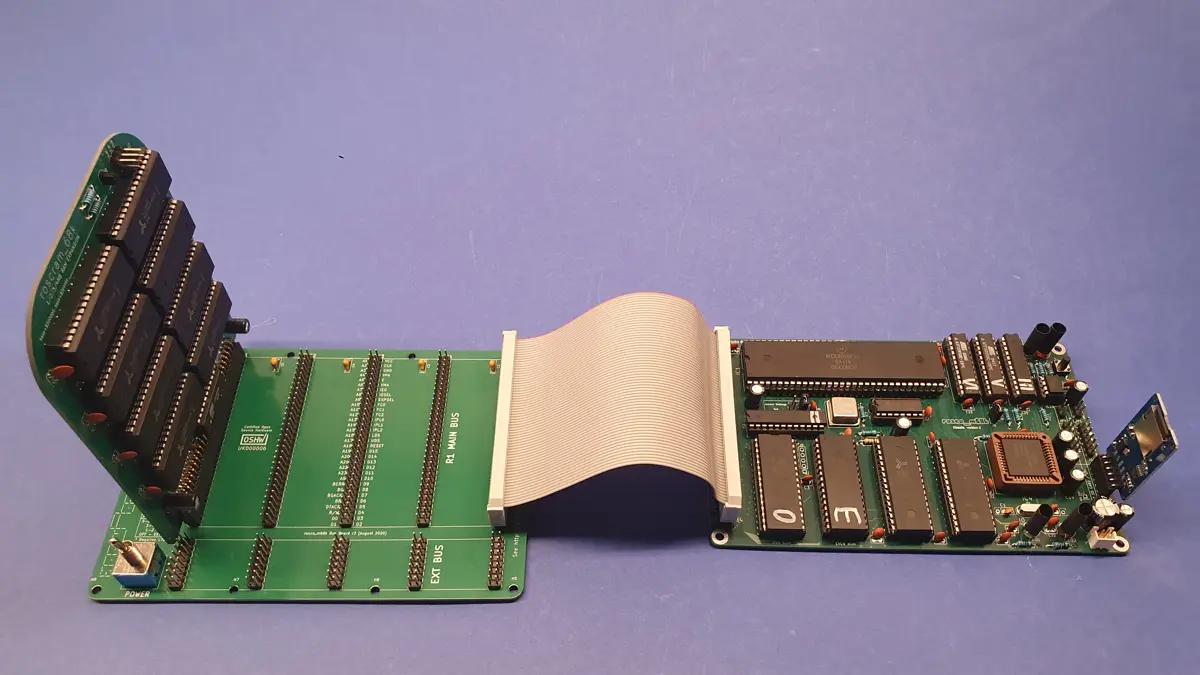
V počítači Rosco_m68k mám 1 MB na desce a 4 MB jako rozšiřující modul zasunutý do sběrnice. Potřeboval jsem ověřit, jestli mám rozšiřující desku správně zapojenou a také jestli propojovací kabel je na 10MHz použitelné řešení. Ano, není! Kabel musel být nahrazen průchozím konektorem.
V počítači 68k-MBC mám 1MB paměti přímo na desce.
Cílem je napsat bare-metal paměťový test, který ověří, jestli je paměť opravdu Ok.
Obecné principy testování pamětí
Naivní přístup spočívající v prostém zapsání a zpětném přečtení jedné hodnoty je pro odhalení skutečných defektů nedostačující. Polovodičová paměť nefunguje jako logická řada softwarových proměnných, ale jako extrémně hustá fyzická matice tranzistorů, u které dochází k parazitním jevům, svodovým proudům a elektromagnetickému rušení.
Vizualizace zde popsaných testů
Anatomie paměťového čipu z pohledu testování
Abychom mohli paměť efektivně testovat, musíme ji vnímat jako systém složený ze tří hlavních bloků, z nichž každý může selhat odlišným způsobem:
-
Paměťová matice: Samotné buňky uchovávající bitovou informaci.
-
Adresní dekodér: Logika, která překládá binární adresu na fyzický výběr konkrétního řádku a sloupce v matici.
-
Logika pro čtení/zápis: Fyzické vodiče (datová sběrnice) a detekce slabého náboje paměťové buňky.
Druhy poruch
Standardizované kategorie chyb, ke kterým v křemíku dochází. Efektivní testovací algoritmus musí matematicky zaručit, že vyvolá a detekuje následující fyzické defekty:
Stuck-at Faults (SAF)
Paměťová buňka je trvale “zaseknutá” na logické nule (SA0) nebo jedničce (SA1). Bez ohledu na to, jaká data do buňky zapisujeme, při čtení vrátí vždy stejnou hodnotu.
Transition Faults (TF)
Chyba přechodu. Buňka sice dokáže uchovat jedničku i nulu, ale nedokáže provést změnu jedním konkrétním směrem. Například přechod z $0 \rightarrow 1$ proběhne v pořádku, ale následný pokus o přechod z $1 \rightarrow 0$ selže a buňka zůstane na hodnotě 1. Tyto chyby často souvisí s poškozenou “pull-down” architekturou tranzistoru.
Coupling Faults (CF)
Vazební poruchy jsou nejhůře detekovatelné defekty, vznikající v důsledku parazitní kapacity mezi sousedními buňkami. Změna stavu v jedné buňce (tzv. agresor) vyvolá nechtěnou změnu stavu v sousední buňce (tzv. oběť). Rozdělujeme je na:
-
Inverzní vazba (Inversion CF): Změna u agresora invertuje stav oběti.
-
Idempotentní vazba (Idempotent CF): Změna u agresora vnutí oběti specifický stav (např. trvale 0), pokud se změna stane.
Address Decoder Faults (AF)
Selhání samotného směrování dat. Často se projevuje takzvaným zrcadlením (aliasing). Z pohledu testu to znamená, že více různých adres ukazuje na jedinou fyzickou buňku, nebo jedna adresa zapisuje data do více buněk současně.
Strategie detekce
Pro odhalení výše zmíněných poruch se využívají sekvenční přístupy, které postupně zatěžují různé aspekty architektury paměti.
-
Topologické testy (šachovnice): Pracují s fyzickým rozložením buněk a vytvářejí maximální šumové pozadí střídáním nul a jedniček. Skvělé pro testování izolačních vlastností buněk.
-
Testy jedinečnosti: Zajišťují, že zápis na adresu $A$ nijak neovlivní data, která posléze přečteme z adresy $B$.
-
March algoritmy: Matematicky exaktní procedury, které pamětí procházejí (pochodují) oběma směry a garantují 100% detekci SAF, TF i AF poruch pomocí definovaných sekvencí čtení a zápisu.
Testování fyzických spojů a sběrnic
Před zahájením komplexních testů samotného křemíku je třeba vyloučit chyby na úrovni plošného spoje a pájených spojů. Pokud by testovací software přistoupil k testu paměťové matice na hardwaru se zkratovanou datovou sběrnicí, výsledky by byly zcela matoucí a nepoužitelné. Diagnostika proto postupuje od procesoru směrem ven — nejprve ověřuje datové vodiče, následně adresní vodiče.
Testování datové sběrnice
Datová sběrnice (v případě architektury m68k typicky 16bitová, D0–D15) je dálnicí, po které putují informace. Mezi nejčastější defekty na této úrovni patří:
-
Přerušený spoj (Floating pin): Špatně propájený pin nedoléhá k plošce na desce. Čtení z takového pinu vrací nedefinovaný stav (často kopíruje sousední piny vlivem parazitní kapacity).
-
Zkrat na napájení nebo zem: Kapka cínu spojila datový pin s VCC (trvalá logická 1) nebo GND (trvalá logická 0).
-
Vzájemný zkrat pinů: Pájecí můstek mezi dvěma sousedními piny (např. D3 a D4) způsobí, že se oba vodiče elektricky ovlivňují.
Metoda Walking 1’s and 0’s
K odhalení těchto chyb stačí mít v celém paměťovém rozsahu jedinou
funkční adresu. Algoritmus na tuto adresu postupně zapisuje hodnoty, ve
kterých rotuje jedna logická jednička na pozadí nul (Walking 1’s):
0x0001, 0x0002, 0x0004, 0x0008 až 0x8000.
Pokud přečtená hodnota neodpovídá zapsané, pin reprezentující jedničku je pravděpodobně spojen se zemí, nebo nedoléhá.
Následně se test opakuje v invertované podobě, kdy obvodem putuje
logická nula na pozadí jedniček (Walking 0’s): 0xFFFE, 0xFFFD,
0xFFFB, 0xFFF7 až 0x7FFF. Tato fáze spolehlivě odhalí zkraty
směrem k napájecímu napětí (VCC) a vzájemné zkraty mezi datovými
linkami.
Testování adresní sběrnice a zrcadlení
Zatímco chyba na datové sběrnici modifikuje samotná data, chyba na adresní sběrnici způsobí, že procesor zapisuje správná data, ale na špatné místo.
Fyzicky je adresní sběrnice (např. A1–A23) sada vodičů určující, která konkrétní buňka se má aktivovat. Pokud je některý z těchto vodičů přerušený, dekodér paměti nedostane plnou informaci.
Zrcadlení adres (Aliasing)
Představme si přerušený vodič adresní linky A15. Procesor se pokusí
zapsat data na adresu 0x008000 (kde A15 = 1). Paměťový řadič ale kvůli
přerušenému spoji přečte A15 jako 0. Data jsou tedy fyzicky zapsána na
adresu 0x000000. Pokud následně procesor přečte adresu 0x000000,
najde zde data, která původně cílil na adresu 0x008000. Paměťový
prostor se v takovém případě tzv. zrcadlí – kapacity paměti se
zdánlivě zmenší na polovinu a systém začne nečekaně přepisovat vlastní
data, což vede k okamžitému pádu běžícího kódu.
Diagnostika unikátním vzorem
Testování adresní sběrnice nelze provést zápisem konstantní hodnoty. Algoritmus musí do každé buňky v paměti zapsat taková data, která jednoznačně identifikují její adresu.
V praxi se používá pseudonáhodný generátor, případně bitový posun (např.
(adresa >> 4) XOR adresa). Tím se vygeneruje 16bitový “podpis” dané
adresy:
-
V zápisové fázi se celá paměť naplní těmito unikátními podpisy.
-
V kontrolní fázi se sekvenčně čte každá adresa.
Pokud hodnota v buňce neodpovídá očekávanému podpisu adresy, znamená to, že mezi koncem zápisové fáze a začátkem kontroly byla buňka přepsána zápisem na úplně jinou adresu. Tím je bezpečně prokázáno, že hardwarový dekodér adres nedokáže odlišit různé části paměťového prostoru a dochází k aliasingu.
Parazitní jevy a topologické testování
Polovodičová paměťová buňka (obzvláště v případě dynamických pamětí DRAM, ale v menší míře i u statických SRAM) není dokonale izolovaný trezor na data. Fyzicky jde o mikroskopickou strukturu tranzistorů a kondenzátorů, které jsou na křemíkovém čipu umístěny v extrémní blízkosti. Tato fyzická těsnost s sebou přináší nežádoucí elektrické interakce, které mohou vést k tiché ztrátě nebo poškození dat vlivem okolí.
Fyzikální podstata problému: Parazitní kapacita
Kdykoliv se v integrovaném obvodu nacházejí dva vodiče s rozdílným elektrickým potenciálem oddělené izolantem (dielektrikem), vzniká mezi nimi nechtěný kondenzátor. Tomuto jevu se říká parazitní kapacita.
Pokud jedna paměťová buňka uchovává logickou jedničku (je nabitá na určitý napěťový potenciál) a sousední buňka uchovává logickou nulu (je vybitá), vzniká mezi nimi elektrické pole. Čím pokročilejší je výrobní proces (a tím menší vzdálenost mezi buňkami), tím silnější je vliv tohoto pole na okolí.
Ztráta náboje a svodové proudy
Z pohledu spolehlivosti nastává kritická situace v momentě, kdy je paměťová buňka s hodnotou 0 obklopena výhradně buňkami s hodnotou 1. Tato “vybitá” buňka je vystavena maximálnímu elektrickému stresu ze všech stran.
Elektrický náboj z okolních buněk může přes nedokonalé izolační vrstvy nebo vlivem subprahových proudů “prosakovat” do naší vybité buňky. Pokud tento parazitní svodový proud dosáhne určité úrovně a mírně zvedne napětí v buňce, paměťový řadič (respektive jeho čtecí zesilovače – sense amplifiers) při čtení mylně vyhodnotí stav buňky jako logickou 1. Dochází k nepozorované ztrátě dat, přičemž chyba neleží v buňce samotné, ale v jejích izolačních vlastnostech a vlivu okolí.
Šachovnicový test
Ke spolehlivé detekci těchto svodových proudů a narušené izolace slouží topologický algoritmus. Jeho cílem není primárně testovat adresování, ale vytvořit v křemíku ten nejhorší možný scénář elektromagnetického rušení.
Algoritmus záměrně naplní celou testovanou oblast střídavým bitovým vzorem, který přímo na fyzické struktuře čipu vytvoří šachovnici plně nabitých a zcela vybitých buněk.
Průběh algoritmu
V typické 16bitové architektuře se test implementuje následovně:
-
Fáze zápisu: Systém střídavě zapisuje vzory. Krok adresy nebo její specifický bit (např. bit 2:
a & 4) rozhoduje o použitém vzoru. Na vybrané adresy se zapíše hodnota0x5555(v binární soustavě střídavé0101010101010101). Na zbylé adresy se zapíše komplementární vzor0xAAAA(binárně1010101010101010). Vznikne tak dokonalá pravidelná struktura, kde každá logická 0 přímo sousedí s logickou 1. -
Teplotní závislost a Burn-in: Protože svodové proudy v polovodičích výrazně rostou s teplotou, je tento typ chyby mnohem častější u zahřátých součástek. Proto se šachovnicový test často začleňuje do nekonečných smyček (burn-in režim), kdy se čeká, až systém dosáhne plné provozní teploty.
-
Fáze kontroly: Z paměti se vzory opětovně sekvenčně přečtou.
Pokud čtecí fáze odhalí i sebemenší odchylku (např. chyba 0x5557
namísto očekávaného 0x5555), je jednoznačně prokázáno, že struktura
čipu nedokáže v náročných podmínkách izolovat sousední náboje. Takový
paměťový čip je nestabilní a bude “widlarizován”.
Detekce dynamických chyb
Algoritmus March C-
Zatímco předchozí metody dokázaly odhalit hrubé hardwarové defekty a
statické poruchy, moderní diagnostika vyžaduje nástroj schopný zachytit
dynamické a časové závislosti. Průmyslovým standardem pro tento účel je
rodina algoritmů March, konkrétně optimalizovaná verze March
C-.
March C- na wiki
Co znamená pojem “March”?
Je to “pochod” paměťovým prostorem. Algoritmus neprovádí náhodné ani izolované operace, nýbrž prochází celou paměť v přesně definovaných sériích (krocích). V každém kroku provede na aktuální adrese operaci čtení či zápisu a následně se posune na sousední buňku buď vzestupně (od nejnižší adresy k nejvyšší), nebo sestupně (odzadu dopředu).
Tento přístup matematicky garantuje 100% detekci:
-
Stuck-at Faults (SAF): Trvale zaseknuté bity.
-
Transition Faults (TF): Neschopnost buňky provést přechod mezi stavy 0 a 1.
-
Address Decoder Faults (AF): Poruchy dekodéru adres.
-
Coupling Faults (CF): Kompletní portfolio vzájemných vazebních poruch mezi buňkami.
Anatomie šesti kroků March C-
Implementovaný algoritmus v našem testovacím kódu sestává ze šesti navazujících fází. Každá fázová sekvence má v testovacím schématu nezastupitelnou roli:
1. Inicializační krok: $M0\lbrack \uparrow (w0\rbrack$
Celá paměť je od nejnižší adresy do nejvyšší (symbol $\uparrow$) naplněna logickými nulami ($w0$). Tím se celý prostor uvede do známého, výchozího stavu.
2. První vzestupný průchod: $M1\left\lbrack \uparrow \left( r0,\text{ w}1 \right) \right\rbrack$
Algoritmus postupuje od začátku do konce. Nejprve buňku přečte a ověří, že obsahuje očekávanou nulu ($r0$) – tím odhalí případné defekty typu SAF-0. Okamžitě poté do ní zapíše jedničku ($w1$). Tento krok odhaluje přechodové chyby při změně z 0 na 1.
3. Druhý vzestupný průchod: $M2\left\lbrack \uparrow \left( r1,\text{ w}0 \right) \right\rbrack$
Opět vzestupný směr. Buňka se nejprve přečte ($r1$ – ověření, že zápis jedničky v předchozím kroku úspěšně proběhl a buňka náboj drží) a vzápětí se do ní zapíše nula ($w0$). Tím se testují přechody opačným směrem ($1 \rightarrow 0$).
4. První sestupný průchod: $M3\left\lbrack \downarrow \left( r0,\text{ w}1 \right) \right\rbrack$
Zde dochází k zásadní změně — pamětí procházíme sestupně od konce směrem k počátku (symbol $\downarrow$). Systém čte nulu ($r0$) a zapisuje jedničku ($w1$). Změna směru v kombinaci s předchozími kroky odhaluje skryté vazební poruchy (Coupling Faults), které se projevují pouze tehdy, když adresa dekodéru přeskakuje v opačném sekvenčním sledu.
5. Druhý sestupný průchod: $M4\left\lbrack \downarrow \left( r1,\text{ w}0 \right) \right\rbrack$
Pokračujeme sestupně. Buňka se přečte jako jednička ($r1$) a následně se do ní zapíše nula ($w0$). Tento krok uzavírá dynamickou smyčku inverzních zápisů.
6. Závěrečná kontrola: $M5\left\lbrack \uparrow (r0) \right\rbrack$
Poslední vzestupný průchod provede už čisté čtení nuly ($r0$) napříč celým prostorem, čímž potvrdí, že závěrečný stav paměti odpovídá očekávání a během testu nedošlo k samovolné reinverzi či ztrátě stability.
Význam burn-in režimu
Algoritmus March C- je extrémně rychlý a efektivní, avšak polovodičové čipy se chovají odlišně za studena a za plného provozu. Z tohoto důvodu se celý proces testování obaluje do nekonečné smyčky (tzv. burn-in režim). Opakováním testu po desítky minut či hodiny se křemík zahřeje na reálnou provozní teplotu. Právě za tepla se nejčastěji projevují skryté výrobní vady, degradované přechody a tepelné rozpínání mikroskopických spojů, které by jednorázový rychlý test mohl zcela přehlédnout.
Detekce chyb časování
Algoritmus March RAW
Zatímco klasický algoritmus March C- exceluje v hledání skrytých vazebních poruch uvnitř křemíkového čipu, v reálném světě mikroprocesorových systémů se často setkáváme s problémy, které neleží v paměti samotné, ale na cestě k ní. Jde především o nedokonalé spoje, zkorodované patice a hraniční zpoždění na sběrnici. Pro tyto případy doplníme testovací sadu o algoritmus zaměřený striktně na časování signálů – March RAW (Read-After-Write).
Signálová integrita a parazitní vliv patic
Vložení paměťového čipu do patice (na rozdíl od jeho přímého připájení na plošný spoj) vnáší do obvodu dva nežádoucí fyzikální jevy:
-
Přechodový odpor: Způsobený nedokonalým mechanickým stiskem pinů nebo jejich mikroskopickou oxidací.
-
Parazitní indukčnost a kapacita: Kovové kontakty patice fungují jako miniaturní cívky a kondenzátory.
Když procesor zapíše do paměti hodnotu (změní stav datového pinu z 0 na 1), napětí na sběrnici nevyskočí z 0 V na 5 V (případně 3.3 V) okamžitě. Kvůli zmíněným fyzikálním jevům má signál pozvolnou “náběžnou hranu” (rise time). Pokud je patice nekvalitní nebo jsou spoje příliš dlouhé, tato hrana se výrazně zpomalí.
Běžný paměťový test (včetně March C-) tuto chybu nemusí odhalit. Důvodem je struktura programové smyčky: mezi instrukcí zápisu a instrukcí následného čtení stejné buňky se často provádí inkrementace adresy, porovnání limitů a skok. Tyto operace poskytnou signálu na sběrnici dostatek času (desítky nanosekund) na to, aby se stabilizoval, než dojde k dalšímu fyzickému přístupu k paměti.
Princip algoritmu March RAW
Algoritmus March RAW je navržen tak, aby paměti, paticím a sběrnici nedal absolutně žádný čas na stabilizaci. Testuje takzvaný nejhorší možný časový scénář.
Jeho implementace v jazyce C je přímočará, ale z pohledu hardwaru extrémně agresivní:
-
Zapiš logickou jedničku ($w1$).
-
Okamžitě (v bezprostředně následujícím strojovém cyklu) ji přečti a ověř ($r1$).
-
Zapiš logickou nulu ($w0$).
-
Okamžitě ji přečti a ověř ($r0$).
-
Teprve nyní se posuň na další adresu.
Zápis sekvence
V šipkoidní notaci March algoritmů by se tento test zapsal zhruba takto: $\updownarrow \left( w1,\text{ r}1,\text{ w}0,\text{ r}0 \right)$
Směr adresování (vzestupně či sestupně) zde nehraje tak zásadní roli jako u vazebních poruch. Absolutně klíčová je absence jakékoliv softwarové prodlevy mezi instrukcemi zápisu a čtení.
Diagnostický význam (Write-After-Read)
Pokud topologický šachovnicový test i dynamický March C- projdou bez chyby, ale March RAW selže, je téměř jisté, že samotný paměťový čip (jeho křemíková matice) je v naprostém pořádku. Diagnostika v takovém případě jednoznačně ukazuje na externí vlivy:
-
Špatný kontakt v patici čipu nebo nedoléhající piny na rozšiřující kartě.
-
Příliš agresivní časování procesoru vzhledem k parametrům použité RAM.
-
Chybějící nebo nedostatečně dimenzované blokovací (bypass) kondenzátory napájení, které nedokážou pokrýt náhlé proudové špičky vzniklé okamžitým střídáním směru toku dat na sběrnici.
Algoritmus pohyblivé inverze (MovInv) a rotace vzorů
Klasické testy typu March zpravidla pracují na úrovni jednotlivých bitů
(plnění paměti absolutní logickou nulou 0x0000 nebo jedničkou
0xFFFF). Zatímco pro detekci vadných buněk to stačí, u 16bitových či
32bitových architektur (jako je Motorola 68000) přistupuje procesor k
paměti v celých slovech. K otestování komplexních vazeb mezi datovou a
adresní sběrnicí zároveň je mnohem efektivnější použít střídavé datové
vzory, které se paměťovým prostorem “pohybují”. Tento přístup se nazývá
Moving Inversion (Pohyblivá inverze).
Princip rotujících vzorů
Algoritmus MovInv nahrazuje statické hodnoty 0 a 1 dynamickými, vzájemně komplementárními vzory. Nejčastěji se využívají “šachovnicová” data:
-
Základní vzor $P_{1}$:
0x5555(binárně0101010101010101) -
Invertovaný vzor $P_{2}$:
0xAAAA(binárně1010101010101010)
Na rozdíl od statického Checkerboard testu, který tyto vzory na střídačku zapíše a nechá je ležet, Moving Inversion vytváří dynamickou vlnu, která pamětí postupně prochází a vzory překlápí.
Průběh algoritmu
V základní verzi (jaká je implementována v našem testovacím kódu) sestává MovInv ze tří kroků:
-
Inicializace: Celý testovaný rozsah je naplněn základním vzorem $P_{1}$.
-
Vzestupná inverze $\uparrow \left( \text{rP}_{1},\text{ wP}_{2} \right)$: Algoritmus prochází paměť od nejnižší adresy k nejvyšší. Z aktuální buňky přečte vzor $P_{1}$, zkontroluje jeho integritu a okamžitě jej přepíše invertovaným vzorem $P_{2}$.
-
Sestupná inverze $\uparrow \left( \text{rP}_{2},\text{ wP}_{1} \right)$: Změní se směr. Algoritmus couvá od nejvyšší adresy zpět dolů. Z buňky čte vzor $P_{2}$ a zapisuje původní vzor $P_{1}$.
Během vzestupného průchodu (krok 2) si můžeme paměť představit jako nádobu, která se postupně plní vzorem $P_{2}$. Pomyslná “hranice” mezi oběma vzory se pohybuje kupředu s tím, jak se inkrementuje adresa.
Diagnostický cíl: Adresní dekodér a přeslechy (crosstalk)
Moving Inversion je mimořádně efektivní v detekci specifické třídy dynamických poruch, které běžné March testy přehlížejí:
-
Závislosti adresního dekodéru na datech: Vnitřní logika paměti sdílí křemíkový substrát pro data i adresy. Při přepisu
0x5555na0xAAAAdochází k masivnímu souběžnému přepnutí všech 16 datových tranzistorů uvnitř paměťového kontroléru. Pokud je adresní dekodér slabě napájen, může tento masivní datový přepínač (data switching noise) způsobit “zakolísání” adresních linek a data se v tu chvíli zapíšou na špatnou fyzickou pozici. -
Elektromagnetický přeslech: Použití datových vzorů střídajících nuly a jedničky maximalizuje kapacitní přeslechy (crosstalk) mezi sousedními vodiči na tištěném spoji desky.
-
Rychlost obnovy: Kontroluje, jak rychle dokážou čtecí zesilovače (sense amplifiers) v čipu rozpoznat složitý vzor poté, co předchozí operace pracovala s jeho přesným opakem, a to vše při současné změně adresního ukazatele.
Algoritmus Moving Inversion je vynikajícím doplňkem k čistě zátěžovému testu March C-. Klade větší důraz na realistický přenos strukturovaných dat a součinnost sběrnice a řadičů se samotným paměťovým čipem.
Algoritmus GALPAT
Limity kvadratické složitosti
Zatímco rodina algoritmů March se snaží najít ideální kompromis mezi důkladností testu a časovou náročností (což se jí s lineární složitostí $O(N)$ daří výborně), existují situace vyžadující absolutní jistotu. Pokud existuje podezření na mimořádně komplexní a vzdálené vazební poruchy (Coupling Faults) napříč celou křemíkovou maticí, nastupuje algoritmus GALPAT (Galloping Pattern). Jde o nejagresivnější a nejdůkladnější známý test paměti, který je však v praxi vykoupen zcela neúnosnou časovou náročností.
Princip “cválající základny”
Název “Galloping Pattern” (cválající vzor) přesně popisuje fyzický pohyb čtecího mechanismu po paměťovém prostoru. GALPAT netestuje jen sousední buňky, ale systematicky prověřuje vliv jedné konkrétní buňky na všechny ostatní buňky v paměti, a to pro každý jednotlivý bit.
Algoritmus pracuje se dvěma pojmy:
-
Základní buňka (Base cell / Agresor): Buňka, která je dočasně aktivována do opačného stavu, než má zbytek paměti.
-
Cílová buňka (Target cell / Oběť): Kterákoliv jiná buňka v paměti, u níž kontrolujeme, zda nedošlo k jejímu ovlivnění.
Krok za krokem
Proces testování probíhá následovně:
-
Příprava pozadí: Celá paměť je naplněna klidovým stavem (např. nulami).
-
Výběr agresora: Algoritmus vybere první adresu v paměti, udělá z ní “základnu” a zapíše do ní invertovanou hodnotu (jedničku).
-
Cval (Gallop): Algoritmus nyní prochází všechny ostatní buňky v paměti (cíle). Z každé cílové buňky přečte nulu a okamžitě po ní si “odskočí” (cválá) zpět přečíst jedničku ze základny. Tím se neustále střídá čtení adresy cíle a adresy základny.
-
Návrat: Základní buňka se vrátí do klidového stavu (nula).
-
Posun: Algoritmus vybere jako novou základnu následující adresu a celý proces cvalu (krok 3) se opakuje pro celý zbytek paměti.
Tato metoda okamžitě odhalí i ty nejslabší kapacitní vazby mezi dvěma libovolně vzdálenými buňkami a garantuje stoprocentní odhalení všech defektů adresního dekodéru.
Proč je složitost $O\left( N^{2} \right)$ neúnosná?
Brutální spolehlivost GALPATu naráží na limity matematiky a fyziky. Protože pro každou jednu buňku (základnu) musíme překontrolovat všechny ostatní buňky v paměti, roste časová náročnost kvadraticky: $O\left( N^{2} \right)$, kde $N$ je počet adres.
Představme si testování $1\text{ MB}$ rozšířené paměti (jako v našem systému m68k). Při 16bitové sběrnici to znamená $524288$ unikátních adres ($N$).
-
Pro první základnu uděláme $524287$ odskoků.
-
Pro druhou základnu dalších $524287$ odskoků.
-
Celkový počet kontrolních cyklů činí $N \times (N - 1) \approx 274,8\text{ miliard operací}$.
Praktické využití dnes
Z důvodu neúnosné kvadratické složitosti se plný GALPAT na kompletní RAM v moderních i retro počítačích při běžné diagnostice již nespouští. Využívá se primárně:
-
Během výroby samotných čipů na specializovaných, extrémně rychlých hardwarových testerech.
-
V softwarových utilitách (jako je náš kód), kde je striktně omezen na miniaturní “okno” paměti (např. pouhé 4 KB), aby test proběhl v rozumném čase (řádově sekundy) a alespoň lokálně prověřil stabilitu buněk a lokálního adresování.
Masivní přesuny paměťových bloků
Zátěžový paměťový test, navržený pro architekturu Motorola MC68010. Cílem algoritmu je simulovat maximální propustnost sběrnice a prověřit stabilitu adresního dekodéru při kontinuálních 32bitových (long-word) sekvenčních přesunech.
Cíl a fyzikální princip testu
Zatímco tradiční algoritmy (jako March C-) testují paměťové na poruchy nebo vzájemné ovlivňování sousedních buněk, Block Shift & Verify agresivně zatěžuje systémovou sběrnici masivním obousměrným přesunem obrovských objemů dat.
Tímto postupem se testuje:
-
Integrita dat pod zátěží: Prověřuje se, zda nedochází k poškození dat (bit-flips) v důsledku zahřívání, šumu na sběrnici nebo vlivu parazitních kapacit.
-
Bezpečné překryvy (Overlapping): Algoritmus garantuje nezkorumpovaný přesun datových bloků i v případě, že se zdrojová a cílová adresa překrývají, čímž nízkoúrovňově simuluje chování standardní C funkce
memmove().
Krok 1: Inicializace náhodnými daty
Testovaný paměťový rozsah od počáteční adresy $S$ do konečné adresy $E$ je nejprve vyplněn pseudonáhodnými daty. K tomu je využit rychlý 32bitový lineární kongruentní generátor (LCG) definovaný vztahem:
$$X_{\left\{ n + 1 \right\}} = \left( X_{n} \times 1103515245 + 12345 \right)\operatorname{mod}\left\{ 2^{\left\{ 32 \right\}} \right\}$$Konstanty použité v textu (násobitel 1103515245 a přírůstek 12345) pocházejí z historického standardu (konkrétně je používala funkce rand() v knihovně glibc pro jazyk C). Generují velmi kvalitní “bílý šum” dat s minimálními výpočetními nároky.
Využití LCG sekvence s počátečním seed 0xDEADBEEF je stěžejní. Na
rozdíl od pevných šachovnicových vzorů (např. 0x5555 a 0xAAAA)
vytváří LCG vysokou entropii dat. Pokud by na adresní sběrnici došlo k
selhání a blok by se zapsal posunutý byť jen o jediný byte, naruší se
predikovatelná posloupnost a verifikační fáze chybu bezpečně zachytí.
pozn. Počáteční seed 0xDEADBEEF je semínko, tedy výchozí hodnota
$X_{0}$, od které se celý generátor odrazí. Hodnota 0xDEADBEEF (“mrtvé
hovězí”) je slavné magické číslo v programování (tzv. hexspeak). Používá
se proto, že pokud vypíšem obsah paměti na obrazovku (memory dump) a
uvidíme tam slovo DEADBEEF, okamžitě rozpoznáme naše testovací data od
náhodné smetí. Díky pevně danému seedu je sekvence “náhodných” čísel
vždy absolutně stejná a predikovatelná. Víme přesně, jaké číslo má být
na jaké adrese zapsáno.
Protože MC68010 disponuje 16bitovou fyzickou datovou sběrnicí, vynutí
zápis 32bitové proměnné (ukazatel unsigned int *) dva bezprostředně po
sobě jdoucí paměťové cykly pro každé zapsané slovo.
Krok 2: Masivní posun nahoru (Shift Up)
V tomto kroku se paměťový blok posune o definovaný offset (např. $O = \ 256\ KB$) směrem k vyšším adresám. Data jsou přesouvána z intervalu $\lbrack S,E - O\rbrack$ do intervalu $\lbrack S + O,E\rbrack$.
Vzhledem k tomu, že se zdrojová a cílová paměťová oblast překrývají a směr přesunu je “nahoru”, musí kopírování probíhat od konce na začátek. Zabrání se tak situaci, kdy by čtecí operace načítala data, která již byla v předchozích iteracích přepsána.
unsigned int *src32 = (unsigned int *)(E - O - 4);
unsigned int *dst32 = (unsigned int *)(E - 4);
while (src32 >= S) { *dst32-- = *src32--; }
Na úrovni strojového kódu tento cyklus využívá adresování s predekrementem -(An), které je na procesorech Motorola 68k vysoce optimalizované.
Krok 3: Masivní posun dolů (Shift Down)
Následně se celý posunutý datový blok vrací zpět na své původní místo. Operace přesouvá masu dat z intervalu $\lbrack S + O,E\rbrack$ zpět do intervalu $\lbrack S,E - O\rbrack$. Nyní se cílová oblast nachází pod zdrojovou. Geometrie překryvu vyžaduje změnu taktiky: kopírování se musí provádět od začátku do konce (vzestupně), aby přesunovaná data “neprchala” před zapisovací hlavou.
unsigned int *src32 = (unsigned int *)(S + O);
unsigned int *dst32 = (unsigned int *)S;
while (dst32 < (E - O)) { *dst32++ = *src32++; }
Zde kompilátor využívá adresování s postinkrementem (An)+.
Krok 4: Striktní verifikace
Poslední fáze ověřuje, zda data po přesunech tam a zpět neutrpěla žádnou
újmu. Program začne znovu na adrese $S$ s původním semínkem 0xDEADBEEF
a vypočítává LCG posloupnost znovu. Každých 32 bitů se porovnává hodnota
přečtená z RAM s vypočtenou hodnotou LCG generátoru. Pokud dojde ke
shodě na všech adresách v rozsahu $\lbrack S,E - O\rbrack$, test prokáže
integritu paměti při masivním přesunu dat.
Je to rychlé
Časová složitost: $O(N)$, kde $N$ je velikost testované paměti. Na rozdíl od kvadratických testů je tento algoritmus poměrně rychlý i při testování několika megabytů dat. Paměťová složitost: $O(1)$. Algoritmus nevyžaduje žádnou dynamickou alokaci paměti; postačí mu interní datové a adresní registry CPU. Zátěž CPU: Prakticky 100%. Díky absenci složité logiky uvnitř while cyklů CPU neustále čte a zapisuje, čímž dochází k maximálnímu vytížení datových a adresních bufferů.
Reálná implementace testu “masivními datovými přenosy”
Základní hraniční parametry použité pro operace nad paměťovými bloky.
-
Startovní adresa bloku ($S$):
0x100000(1 MB) -
Konečná adresa bloku ($E$):
0x4FF000(přibližně 5 MB) -
Velikost přesouvaného bloku (Offset, $O$):
0x40000(256 KB)
Fáze 1: Vyplnění paměti ($S \rightarrow E$)
Prvním krokem je vyplnění 32bitových paměťových slotů v rozsahu $S$ až $E$ vygenerovanými pseudonáhodnými daty.
-
Začátek čtení: Neaplikuje se (využití LCG s počátečním seedem
0xDEADBEEF) -
Konec čtení: Neaplikuje se
-
Začátek zápisu:
0x100000($S$) -
Konec zápisu:
0x4FF000($E$)
Fáze 2: Přesun bloku nahoru ($S \rightarrow S + O$)
V tomto kroku simulujeme chování funkce memmove() s překrývajícími se
adresami, posouvající data o offset $O$ nahoru.
-
Odkud se kopíruje (src): Rozsah
0x100000až0x4BFFFF($S$ až $E - O$) -
Kam se kopíruje (dst): Rozsah
0x140000až0x4FF000($S + O$ až $E$) -
Směr kopírování: Sestupný (od $E - 4$ do $S + O$ pro cílovou adresu, aby se nepřepisovala zdrojová data dříve, než se přečtou).
Fáze 3: Přesun bloku dolů ($S + O \rightarrow S$)
V tomto kroku vracíme data z posunutého umístění zpět na původní adresu.
-
Odkud se kopíruje (src): Rozsah
0x140000až0x4FF000($S + O$ až $E$) -
Kam se kopíruje (dst): Rozsah
0x100000až0x4BFFFF($S$ až $E - O$) -
Směr kopírování: Vzestupný (od $S$ do $E - O - 4$ pro cílovou adresu).
Fáze 4: Verifikace integrity dat
Finálním krokem je opětovné vygenerování LCG řady s výchozím seedem a porovnání s daty z paměti po dokončení přesunu.
-
Začátek čtení:
0x100000($S$) -
Konec čtení:
0x4BFFFF($E - O$)
Organizace paměti pro bare-metal (M68k)
Ověřeno na 68010 a 68008.
Při vývoji softwaru typu bare-metal (bez operačního systému) pro procesory rodiny Motorola 68k leží veškerá zodpovědnost za správu paměti na vývojáři a linker skriptu. Procesor neposkytuje žádnou virtuální paměťovou abstrakci – kód pracuje s přímými fyzickými adresami.
Tabulka vektorů přerušení (Exception Vector Table)
Základním stavebním kamenem architektury M68k je tabulka vektorů, která
se po tvrdém resetu nachází vždy na nejnižších adresách: 0x000000 až
0x0003FF (prvních 1024 bajtů).
Tabulka obsahuje 256 vektorů (každý o velikosti 32 bitů), které ukazují na adresy obslužných rutin (Interrupt Service Routines - ISR, Trapů a chybových stavů). Dva nejdůležitější vektory leží na samém začátku:
-
0x000000(SSP): Počáteční hodnota Supervisor Stack Pointeru (načte se do hardwarového registruA7). -
0x000004(PC): Počáteční hodnota Program Counteru (adresa, na které začíná startovací bootovací kód).
Poznámka pro MC68010: Na rozdíl od původního MC68000 disponuje model 68010 registrem VBR (Vector Base Register), který umožňuje celou tabulku vektorů za běhu přesunout na jinou adresu v paměti. Po zapnutí nebo resetu je VBR hardwarově vždy vynulován.
Struktura programu v paměti (Linker sekce)
Když nástroj m68k-elf-gcc zkompiluje váš C nebo Assembly kód, Linker
rozloží binární soubor do několika logických bloků. U desek jako
rosco_m68k se tyto sekce obvykle nahrávají hned za vektory přerušení (od
adresy 0x000400), případně od adresy dané Linker skriptem.
.text-
Obsahuje samotné strojové instrukce programu (kód). V klasických systémech s EPROM by tato sekce ležela v nepřepisovatelné paměti, u bare-metal vývoje je běžně nahrávána celá do SRAM.
.rodata-
Sekce konstant a textových řetězců (Read-Only Data). Nachází se zde například formátovací řetězce pro funkci
printf. .data-
Inicializované globální a statické proměnné. Jde o proměnné, kterým vývojář v C kódu explicitně přiřadil konkrétní hodnotu (např.
int speed = 115200;). .bss-
(Block Started by Symbol) Neinicializované globální proměnné, které mají mít po spuštění hodnotu nula. Tyto proměnné nejsou fyzicky zapsány v binárním
.binsouboru, aby se šetřilo místo. Startovací kód (tzv. C runtime init) tuto sekci v paměti při bootování hardwarově vynuluje.
Konec sekce .bss je označen speciálním symbolem, který generuje
Linker, obvykle pojmenovaným _end. Od této adresy výše začíná “volná
paměť” systému.
Zásobník (Stack) a jeho růst
Architektura M68k používá registr A7 jako hardwarový ukazatel
zásobníku (Stack Pointer). Zásobník uchovává návratové adresy funkcí,
předávané parametry a lokální proměnné funkcí.
Zásobník roste shora dolů (od vyšších adres k nižším). Typicky se
umisťuje na úplný konec dostupné fyzické paměti RAM (například těsně pod
hranici 1 MB, nebo 5 MB). Pokud program spotřebuje příliš mnoho paměti
na zásobníku (např. hlubokou rekurzí nebo alokací obřích lokálních
polí), může zásobník propadnout až do sekce .bss nebo .data. To vede
k tichému zhroucení systému (tzv. Stack Collision).
Příklad typické mapy paměti
Níže je znázorněna mapa paměti typické C bare-metal aplikace běžící v základní RAM zhruba o velikosti 5 MB.
| Hex adresa | Sekce paměti | Popis / Funkce |
0x000000 |
Exception Vectors | Vektory přerušení (SSP, PC, Trap, IRQ) |
0x000400 |
.text |
Výkonný kód programu |
... |
.rodata |
Konstanty (např. stringy pro UART) |
... |
.data |
Inicializované proměnné programu |
... |
.bss |
Při startu nulované proměnné |
&_end |
Volná paměť | Prostor využitelný pro alokaci (Heap) či low-level paměťové testy. Adresace roste nahoru. |
... |
↓ Kolidní zóna ↑ | Prázdný ochranný prostor (pokud dojde, program spadne) |
0x4FFFC8 |
Stack (A7) | Zásobník programu. Roste směrem dolů k volné paměti. |
0x500000 |
Konec RAM | Fyzický konec limitu adresace dostupného bloku paměti. |
Pravidla zarovnání adres (Alignment constraint)
Kritickým specifikem procesorů MC68000 a MC68010, na které je nutné brát
zřetel při jakýchkoliv vlastních operacích s ukazateli (včetně výpočtů
volné paměti za symbolem _end), je požadavek na striktní zarovnání
paměti (Alignment).
-
Přístup k datům o velikosti jednoho bajtu (8 bitů, v C reprezentováno jako
char) je povolen na jakékoliv adrese (sudé i liché). -
Přístup k datům o velikosti slova (16 bitů,
short) nebo dvojslova (32 bitů,int/long/ pointery) musí probíhat výhradně na sudých adresách (adresy dělitelné dvěma). -
Instrukce musejí být rovněž umístěny výhradně na sudých adresách.
Pokud se program pokusí načíst nebo zapsat 16bitovou či 32bitovou
hodnotu na lichou adresu, procesor tuto akci hardwarově zablokuje a
okamžitě vyvolá výjimku Address Error (vektor 3). Program následně
zhavaruje. Z tohoto důvodu musí být v kódu dynamické ukazatele na
začátky bloků vždy ručně zarovnávány (například bitovou maskou nahoru:
(addr + 1) & ~1 nebo na 4 bajty (addr + 3) & ~3).
Program detekuje volnou paměť pro testování
Při psaní paměťového testu (nebo při implementaci vlastního alokátoru
typu malloc) pro bare-metal systém potřebujeme přesně vědět, kde náš
zkompilovaný program v paměti končí a kde má procesor svůj zásobník
(Stack). Pokud bychom tyto adresy do kódu napsali natvrdo, program by po
každém přidání nové funkce narostl a test by následně
přepsal sám sebe.
Musíme tyto hranice detekovat dynamicky za běhu programu pomocí jazyka C, ukazatelů a bitové matematiky.
Nalezení konce programu: Symbol _end
Během kompilace spojuje Linker všechny sekce (.text, .data, .bss)
za sebe. Za poslední sekcí vygeneruje virtuální značku – symbol s
názvem _end.
Abychom k této značce mohli z jazyka C přistoupit, musíme ji deklarovat:
extern char _end;
Důležitý koncept C / Linkeru: Proměnná
_endneexistuje jako skutečná datová proměnná v paměti (nezabírá žádný bajt, do kterého bychom mohli něco zapsat). Je to pouze návěští (štítek), který existuje v tabulce symbolů. Zajímá nás proto výhradně její adresa v paměti, nikoliv její hodnota!
Abychom získali konkrétní číselnou adresu, použijeme operátor reference (&) a výsledek přetypujeme (tzv. type casting) z ukazatele (pointeru) na celočíselný typ unsigned int, se kterým můžeme matematicky pracovat:
unsigned int program_end = (unsigned int)&_end;
Pokud Linker umístil konec sekce .bss například na adresu $009F55,
bude mít proměnná program_end hodnotu 0x009F55.
Matematika zarovnání adres (Alignment)
Víme, že procesor M68k nedokáže přistupovat k 16bitovým a 32bitovým hodnotám na lichých adresách. Pokud konec programu (program_end) vyjde na lichou adresu, musíme ji zarovnat nahoru na nejbližší sudou adresu (nebo ještě lépe, pro 32bitovou sběrnici, na násobek 4).
K tomu se v nízkoúrovňovém programování nepoužívá dělení ani modulo (které jsou výpočetně náročné), ale bitové operace:
unsigned int safe_start = (program_end + 3) & ~3;
Takto zvolená proměnná safe_start běžela s jistotou na Rosco m68k na 68010,
ale na 68k-MBC s 68008 program havaroval, protože test přepsal buď buffer prinf
nebo výstupu na sériový port, proto takticky navýšíme hodnotu safe_start o 16kB
  // PŘIDÁME 16 KB (0x4000) rezervu pro heap (printf buffery)
  unsigned int safe_start = ((program_end + 3) & ~3) + 0x400
Pro (adresa + 3) & ~3 zarovnává správně
Tento podivný zápis je průmyslovým standardem pro zarovnání nahoru.
Jak funguje:
~3(Bitová inverze): Číslo 3 je v binární soustavě 00000011. Operátor (NOT) bity převrátí na 11111100.
&(Bitový AND): Pokud jakoukoliv adresu spojíme operátorem AND s maskou 11111100, vynulujeme její dva nejnižší bity. Tím libovolné číslo zarovnáme dolů na nejbližší násobek 4.
+3 (Posun nahoru): Abychom nezarovnávali dolů (čímž bychom zasáhli do našeho vlastního programu), ale nahoru, přičteme před aplikací masky číslo 3 (což je požadované zarovnání 4 mínus 1).
Příklad výpočtu (konec programu na $009F55):
0x9F55 + 3 = 0x9F58
0x9F58 binárně končí na …1000
Operace AND s …1100 nezmění výsledek. Konečná adresa je 0x9F58.
(Tato adresa je perfektně dělitelná 4).
Detekce zásobníku (Stack Pointer)
Zásobník na M68k roste shora dolů. Potřebujeme zjistit, kde se právě nachází, abychom nenarušili běh aktuální funkce (např. lokální proměnné funkce main). Jazyk C nemá standardní příkaz pro čtení hardwarových registrů procesoru. Musíme proto využít “inline assembler”:
unsigned int get_sp(void)
{
    unsigned int sp_val;
    // Přesuň (move.l) hodnotu registru SP do výstupní proměnné %0
    __asm__ __volatile__ ("move.l %%sp, %0" : "=r" (sp_val));
    return sp_val;
}
unsigned int current_sp = get_sp();
Klíčové slovo volatile říká překladači GCC, aby tuto instrukci neoptimalizoval a nepřeskupoval, protože její výsledek závisí na přesném okamžiku vykonání.
Výpočet konce bezpečné zóny
Nyní víme, kde náš program aktuálně končí (zdola) a kde začíná zásobník (shora). Nemůžeme však testovat paměť až k samotnému okraji zásobníku. Program potřebuje “dýchat” – například funkce printf si při formátování textu na zásobník dočasně ukládá poměrně velká pole.
Proto od aktuálního zásobníku odečteme “ochranný polštář” (například 8 KB) a výsledek opět zarovnáme na násobek 4:
// 0x2000 je 8192 bajtů (8 KB)
unsigned int safe_end = (current_sp - 0x2000) & ~3;
Výsledkem celého tohoto procesu jsou dvě proměnné (safe_start a
safe_end), které naprosto přesně definují hranice bloku RAM, který lze
100% bezpečně a bez následků vystavit i těm nejdestruktivnějším
paměťovým testům.